Infrastruktur AI berkembang pesat, tapi ada satu lagi aspek yang perlu kita bincang dalam operasi harian: penggunaan elektrik, penyejukan dan air.
Penyelidikan terkini menunjukkan bahawa setelah model AI digunakan, inferens boleh mengambil kira 80–90% daripada penggunaan tenaga keseluruhan. Setiap panggilan LLM yang tidak perlu bermakna lebih banyak compute GPU, lebih banyak elektrik, lebih banyak haba, dan akhirnya lebih banyak permintaan penyejukan.
Ini antara sebab kami membangunkan NeuralOps berdasarkan prinsip yang berbeza:
Bukan setiap tugas memerlukan LLM.
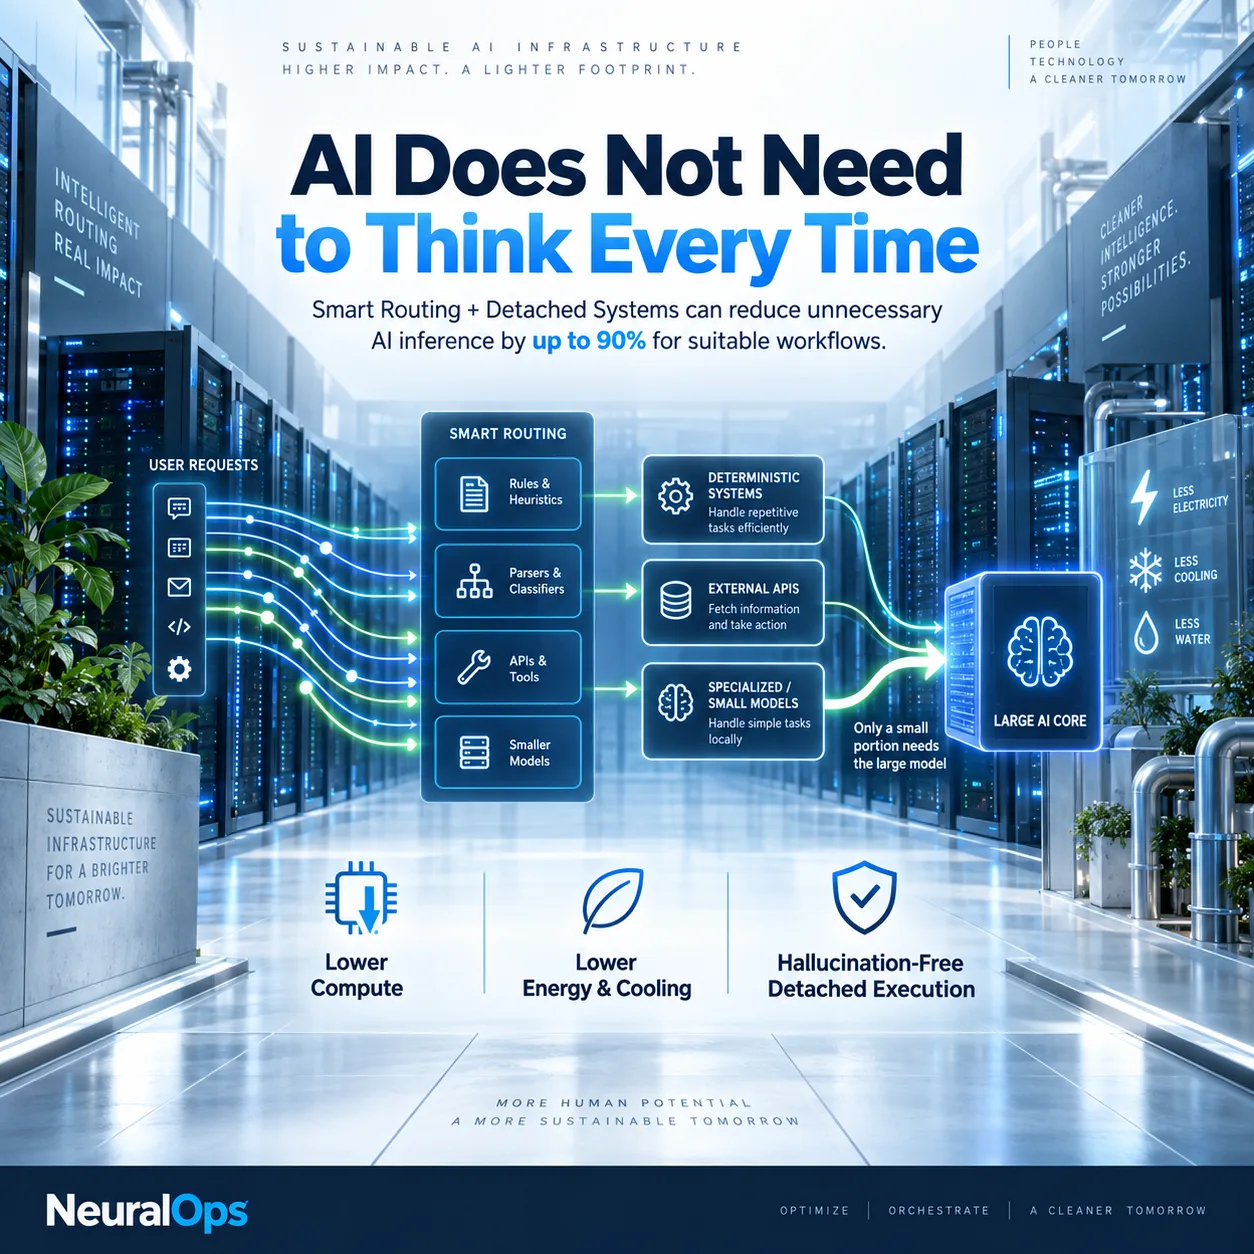
Dengan 智能路由, sesuatu tugas boleh dikendalikan dahulu oleh peraturan, parser, pangkalan data, API atau model yang lebih kecil. Penaakulan LLM yang berat hanya digunakan apabila benar-benar diperlukan. Setelah aliran kerja menjadi stabil, ia boleh ditukar menjadi sistem deterministik yang terpisah yang dilaksanakan berulang kali tanpa memanggil LLM.
Untuk aliran kerja berulang yang sesuai, seni bina ini berpotensi mengurangkan permintaan inferens AI sebanyak sehingga 90%.
Kesan ini bukan sahaja pada penjimatan token.
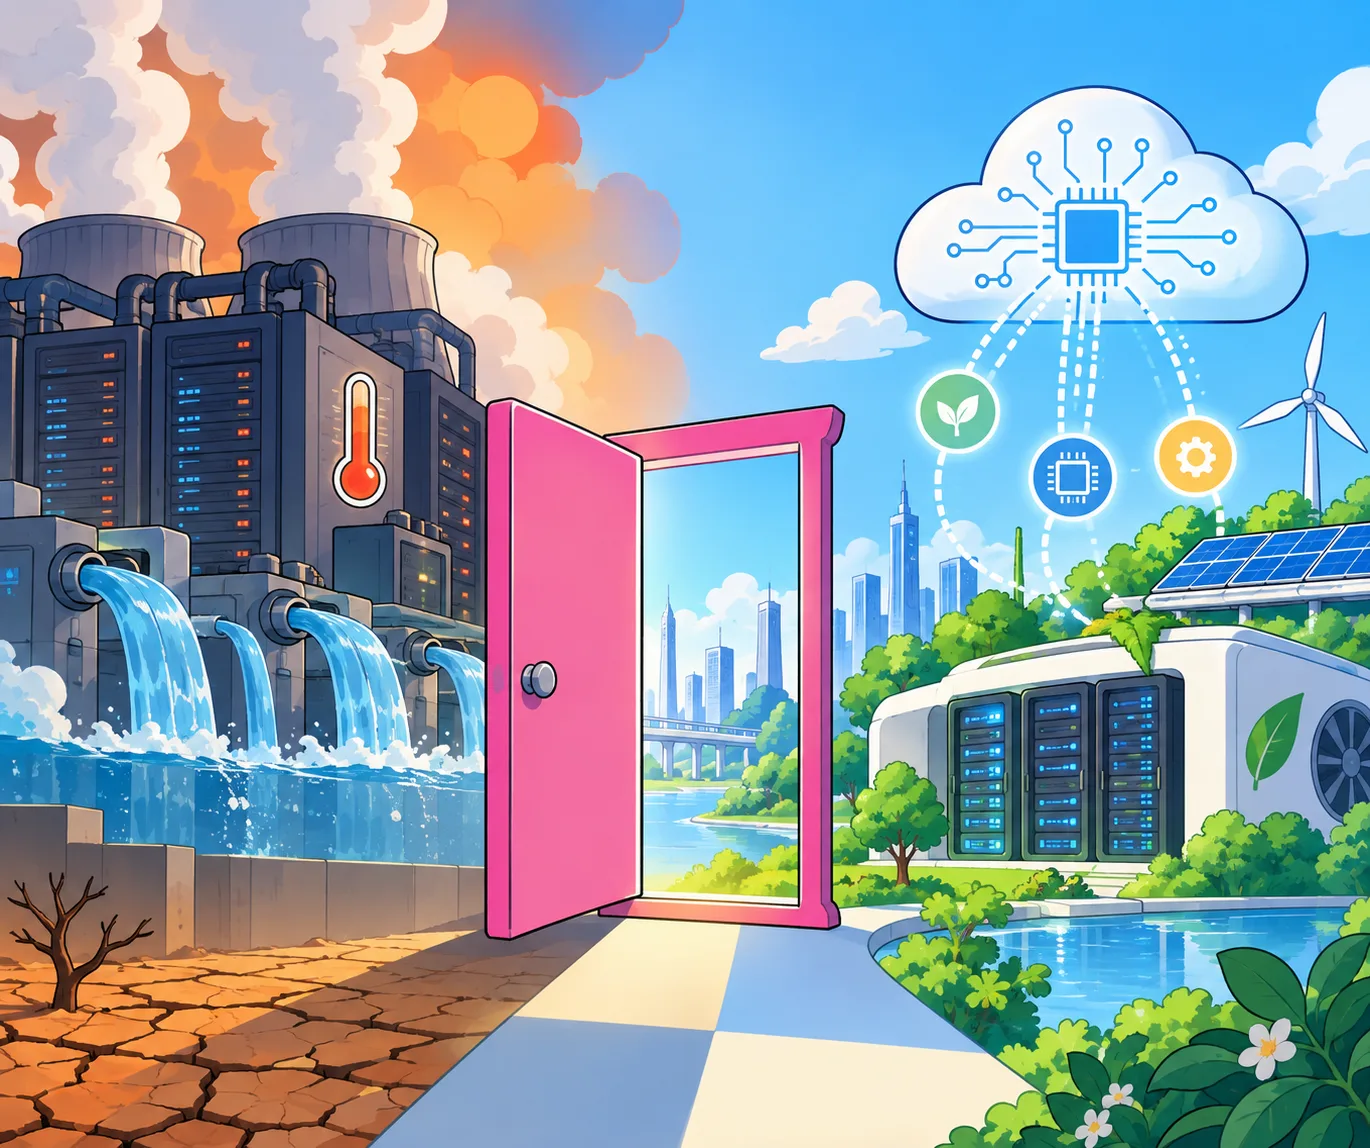
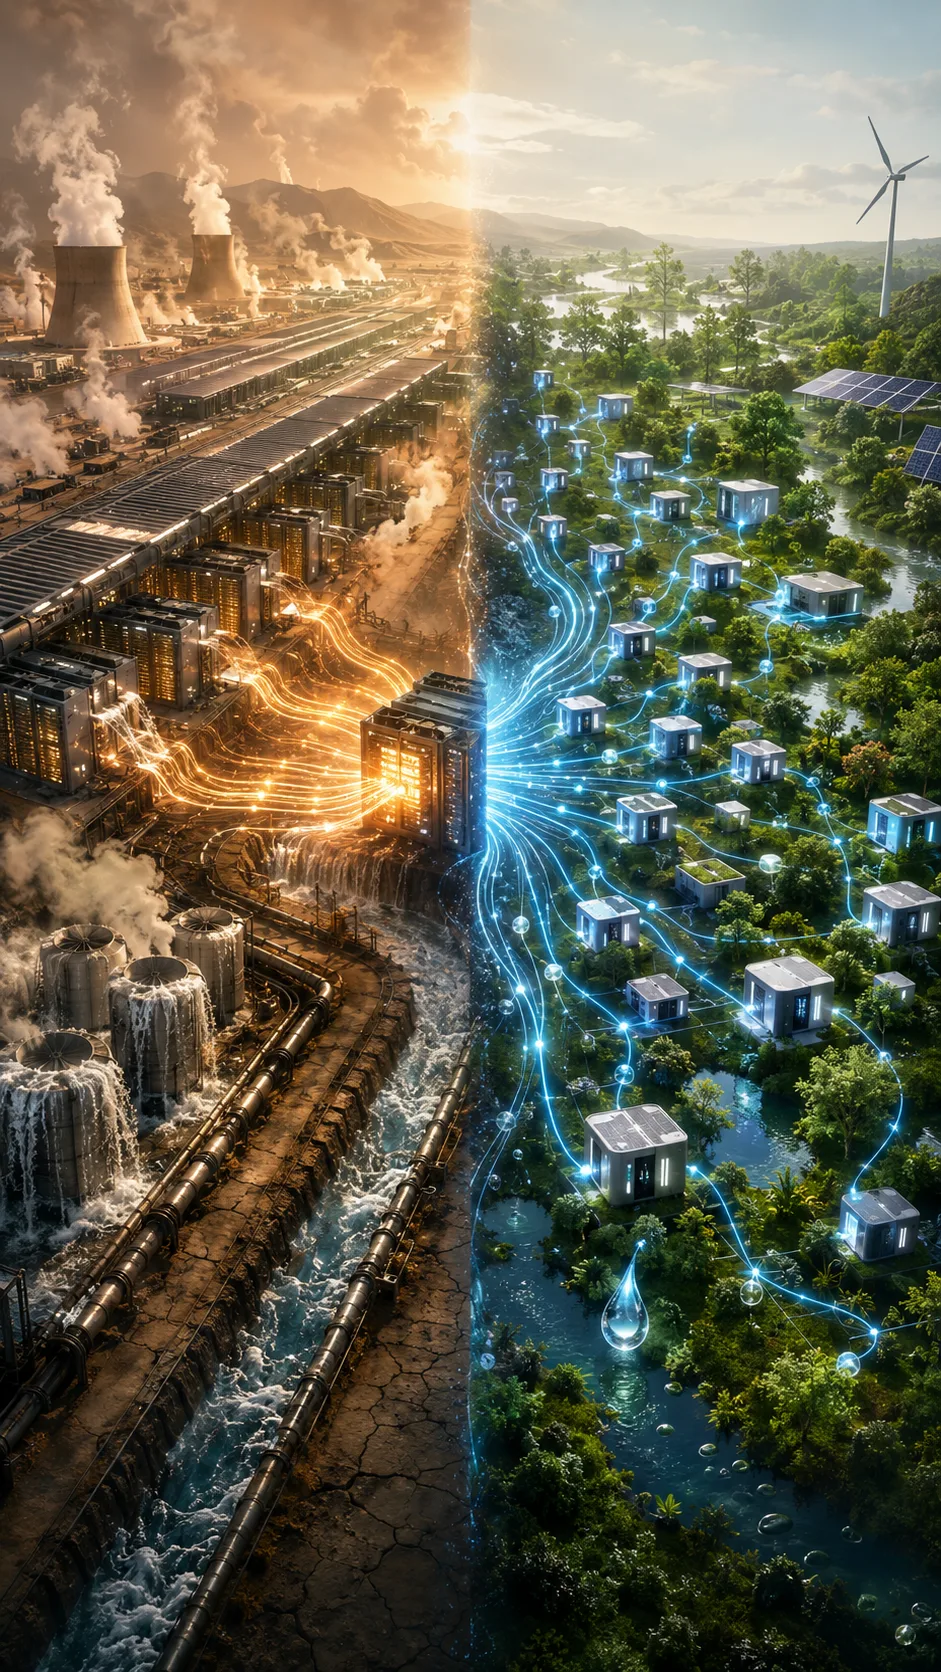
Kurang inferens → Kurang compute GPU → Kurang elektrik → Kurang haba → Kurang penyejukan → Kurang permintaan air.
Ada lagi satu faedah: kebolehpercayaan.
Apabila aliran kerja terpisah tidak lagi bergantung pada LLM semasa pelaksanaan, terdapat sifar token LLM dan sifar halusinasi LLM sepanjang laluan pelaksanaan tersebut. Kepintaran digunakan di mana penaakulan diperlukan, manakala sistem deterministik mengendalikan operasi berulang.
Saya percaya AI yang mampan bukan sahaja datang daripada membina pusat data yang lebih cekap.
Ia juga datang daripada mencegah inferens AI yang tidak perlu daripada sampai ke pusat data sejak awal.
Itulah hala tuju yang kami terokai dengan NeuralOps:
gunakan AI apabila kepintaran diperlukan, dan gunakan sistem deterministik apabila tidak.
#ArtificialIntelligence #AgenticAI #NeuralOps #SovereignAI #GreenAI #SustainableAI #DataCentre #AIInfrastructure #SmartRouting #自动化 #中小企业


Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
同意作者对penaakulan LLM yang berat hanya的判断,但执行起来还有难度。
总结部分让ia boleh ditukar menjadi sistem的重点更加清楚。
这篇文章对lebih banyak elektrik, lebih banyak的解释很清楚,实际操作的重点也很容易理解。
关于mengambil kira 80–90 90%的实际落地部分最吸引我。 值得再看一遍。
我对sebanyak sehingga 90%.Kesan 90%还有问题,但文章已经提供了很好的起点。
收藏了,主要是为了penggunaan elektrik, penyejukan dan。
视觉和结构让seni bina ini berpotensi mengurangkan的概念更容易掌握。 这点我还要再消化一下。
看第二遍才注意到dan akhirnya lebih banyak permintaan的细节。
这篇文章适合团队用来开始讨论sesuatu tugas boleh dikendalikan dahulu。
如果有更多kebolehpercayaan.Apabila aliran kerja terpisah的数据和结果会更完整。
这篇内容让我更容易理解为什么inferens boleh mengambil kira 80–90%值得关注。
文章对infrastruktur AI berkembang pesat, tapi的结论比较平衡,不只是强调好处。
80这部分我看了几遍,值得再想。
第一次看到有人把80讲得这么坦白。 这点我还要再消化一下。
我特别喜欢setelah aliran kerja menjadi stabil这一部分,内容没有把实施过程说得太简单。
文章把parser, pangkalan data, API atau和日常运营联系起来,这一点很有帮助。