精选
核心8
AINNA
首页与公司中心
新
推进
NeuralOps automation & business 系统
ESG
可持续性与影响
新
碳模拟器
碳足迹计算器与智能路线模拟器
NeuralOps
AINNA 平台的智能内核
AINNA智能体
数字化劳动力
私有 AI 基础设施
为 AINNA 提供的私有模型和基础设施
Locations
Find AINNA in 马来西亚 — HQ & directions
AINNA智能体1
新
AINNA智能体
数字化劳动力
解决方案6
商业 & 中小企业
面向企业和中小企业的 AI 解决方案
新
中小企业AI能力
面向中小企业的培训、基础设施与业务系统
企业版
企业级 AI 服务与运营
政府与智慧城市
面向政府和智慧城市运营的安全 AI
新
PQR1 — Sari Tani
项目制 PDF OCR、指定页面及质量保证审查
行业
行业专属的 AI 运营与启动平台
科技5
智能路由
将每项任务路由到正确的模型和执行路径
分离式系统
由 AI 构建并可独立运行的系统
AI 合规
代理、LLM工作流及分离式 系统的审计、QA与质量控制
模型与基础设施
驱动 AINNA 的模型、算力与基础设施
数据智能
市场数据、分析与运营智能
证明4
实时系统
互动式 NeuralOps 系统与演示
案例研究 / 证据
技术证据、基准测试和运营案例研究
研究
基于证据的科学与工程研究
新
可折叠干燥系统
模块化 IoT 干燥平台,配备 智能体 AI 异常监测功能(PoC)
投资者5
投资者 Hub
AINNA 投资者概览、融资需求与战略资料
提案 Decks
AINNA 演示文稿与投资者建议书
新
AINNA Publishing 电网
一个发布核心,支撑多元化出版物组合
市场与战略
市场方向、物流路线图与上市策略
技术架构
NeuralOps 模型、路由与基础设施架构
团队12
中心
AINNA 团队
领导层、专家以及 AINNA 背后的团队
创始人兼首席执行官
Nur Ain Syuhada
客户战略总监
Rozni Enana
联合创始人兼技术总监
Masli Yahaya
财务与会计部
Badrul Haziq
联合创始人兼物流主管
Hakim Hafizi
联合创始人兼研发部主管
Muhammad Hakam Hafizul
运营与业务发展
Muhammad Firdaus Bin Nordin
电子商务运营
Mohd Shafiq Haiqal
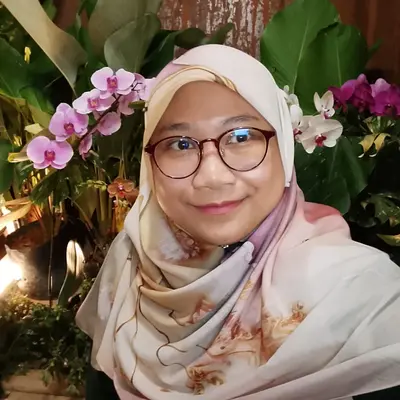
生产规划与运营
Siti Nur Najiha
AI 系统开发工程师
Agent TC
研究员
Dr. Abd Razzif Bin Abd Razak
工具与实验2
AI工具
免费在线工具目录
AI实验与游戏
街机、益智与纸牌游戏中心
内容2
AI洞见
关于AI与机器学习的文章
技术洞见
产品与工程
管理后台1
中心
管理后台
AINNA 运营、会计与指挥界面