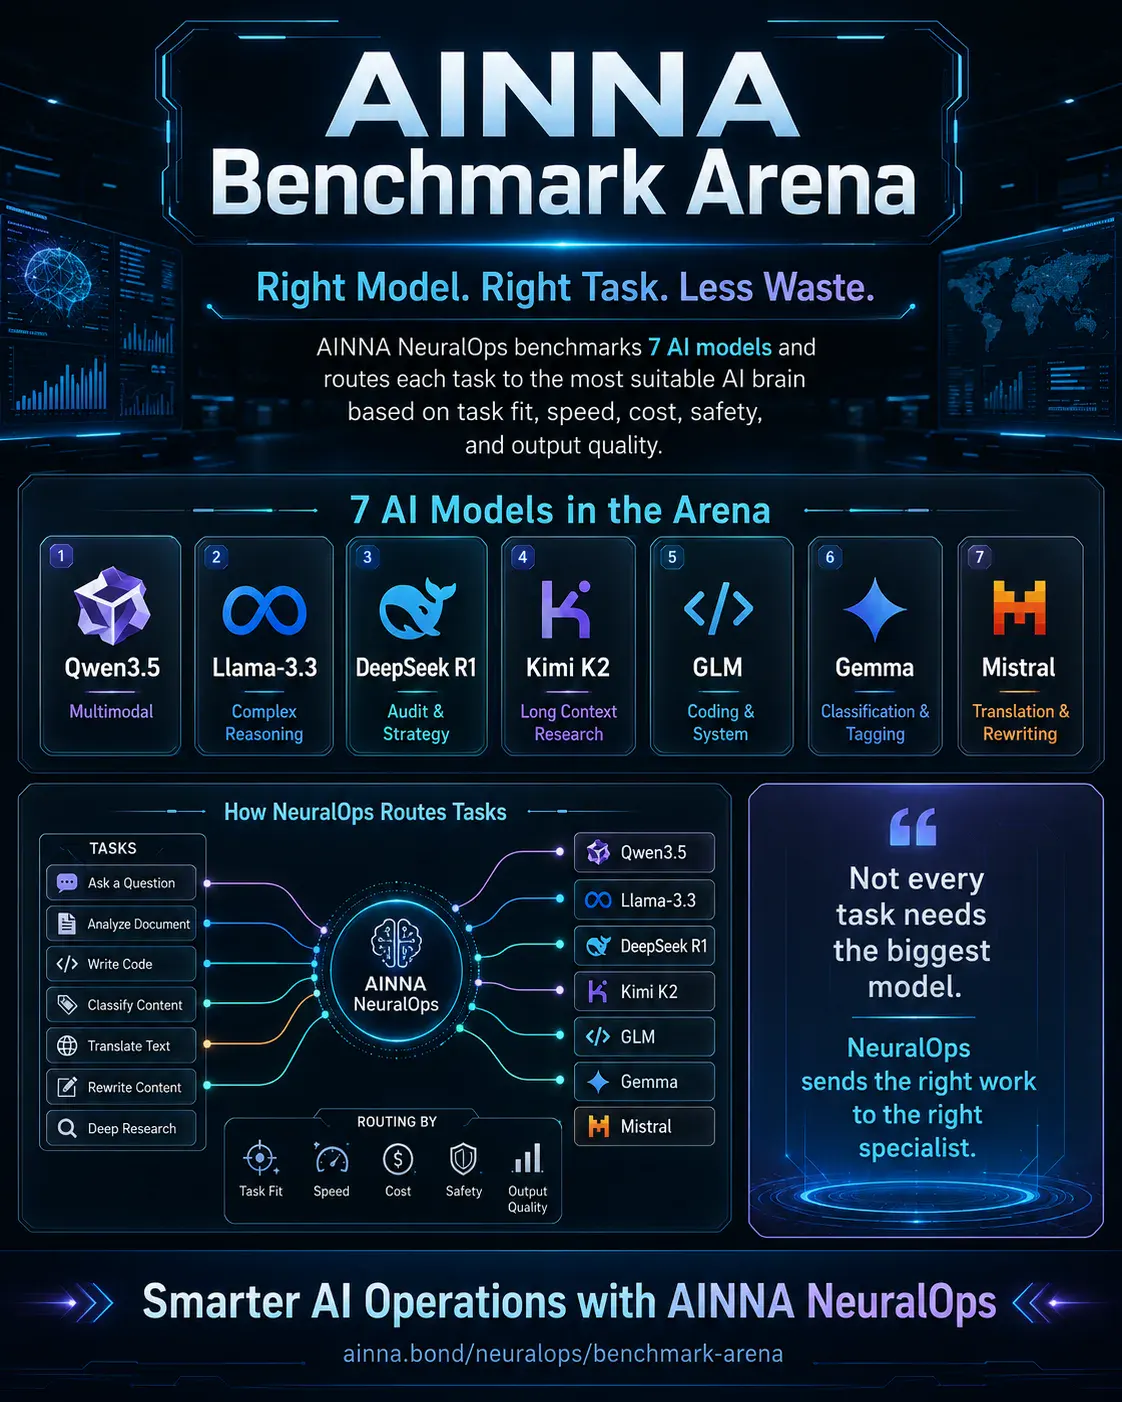
AINNA 基准竞技场:正确的模型,正确的任务,更少的浪费。
Dalam perancangan operasi AI, kita tidak boleh menjadikan "model terbesar" sebagai piawai untuk setiap tugas.
Dari sudut pandang perancangan pengeluaran, pendekatan sedemikian mungkin kelihatan baik atas kertas, tetapi apabila diletakkan dalam barisan operasi sebenar, ia menghasilkan kos berlebihan, tempoh pelaksanaan lebih lambat, penggunaan token yang tinggi, dan pembaziran sumber komputasi. Di AINNA, soalan yang lebih bijak bukanlah, "模型 AI mana yang paling berkuasa?" Soalan sebenarnya ialah, "模型 manakah yang paling sesuai untuk tugas tertentu ini?"
Inilah asas pembangunan AINNA Benchmark Arena.
AINNA Benchmark Arena direka sebagai lapisan penilaian model dan routing tugas dalam AINNA NeuralOps. Ia menilai prestasi pelbagai model AI berdasarkan keperluan operasi sebenar seperti analisis multimodal, kajian dokumen panjang, semakan pematuhan, pengaturcaraan, pembaikan sistem, klasifikasi, penandaan, terjemahan, penyuntingan semula, dan penaakulan strategik.
Dalam susun atur NeuralOps kami, setiap model diberi peranan tertentu seperti stesen kerja dalam satu lantai pengeluaran. Qwen3.5 ditempatkan untuk tugas multimodal melibatkan teks, imej, tangkapan skrin, dan visual produk. Llama-3.3 digunakan untuk penaakulan kompleks dan tugas umum tahap tinggi. DeepSeek R1 ditugaskan untuk audit, pematuhan, semakan risiko, dan perancangan strategik. Kimi K2 digunakan untuk kajian konteks panjang dan analisis dokumen berat. GLM diperuntukkan untuk pengaturcaraan, penjanaan sistem, dan pembaikan teknikal. Gemma mengendalikan klasifikasi pantas, penandaan, dan pengesanan niat. Mistral menyokong terjemahan, penyuntingan semula, dan penambahbaikan bahasa.
Ini di mana 智能路由 menjadi sangat penting.
Tidak semua tugas memerlukan model raksasa. Klasifikasi mesej pelanggan yang mudah tidak memerlukan lapisan kecerdasan yang sama seperti audit pematuhan strategik. Tag produk pendek tidak memerlukan komputasi yang sama seperti perbandingan dokumen panjang. Pembaikan pepijat laman web tidak memerlukan model yang sama seperti analisis imej poster. Setiap tugas layak mendapat pakar yang tepat.
Satu analogi yang sering saya gunakan ialah lantai pengeluaran. Tidak semua kerja memerlukan mesin CNC 5-paksi. Sesetengah kerja hanya memerlukan mesin potong ringkas. Sesetengah memerlukan operator kemahiran tinggi. Sesetengah memerlukan juruaudit kualiti. Sesetengah memerlukan jurutera penyelenggaraan. Apabila tugas yang betul dihantar ke stesen kerja yang betul, seluruh barisan pengeluaran menjadi lebih pantas, lebih kemas, dan lebih cekap.
AINNA Benchmark Arena bukan sekadar carta kedudukan. Ia bukan dibina untuk mengisytiharkan satu model sebagai juara mutlak. Sebaliknya, ia mengukur prestasi model merentasi beberapa dimensi operasi: ketepatan, kesesuaian tugas, kelajuan, kecekapan kos, keselamatan pematuhan, dan tahap penyuntingan manusia yang diperlukan.
Ini penting kerana penggunaan AI dalam dunia sebenar bukan sahaja tentang kecerdasan. Ia juga melibatkan kemampanan, konsistensi, kos operasi, dan kawalan risiko.
模型 yang memberikan jawapan cantik tetapi memerlukan banyak penyuntingan tidak semestinya pilihan terbaik. 模型 yang sangat cerdas tetapi terlalu mahal untuk tugas mudah tidak cekap dari sudut operasi. 模型 yang pantas tetapi lemah dalam semakan pematuhan tidak sesuai untuk tuntutan sensitif. Matlamatnya bukan untuk menggunakan lebih banyak AI. Matlamatnya ialah menggunakan AI dengan lebih bijak.
Bagi AINNA, ini menyokong visi yang lebih besar: NeuralOps sebagai lapisan operasi untuk pelaksanaan AI yang cekap.
Kombinasi penanda aras, 智能路由, dan pelaksanaan terpisah membolehkan kami mengurangkan komputasi yang tidak perlu sambil meningkatkan kualiti output. Berbanding mengekalkan setiap ejen atau model aktif sepanjang masa, AINNA NeuralOps hanya mengaktifkan keupayaan yang tepat apabila diperlukan. Ini menghasilkan seni bina AI yang lebih praktikal dan boleh skala untuk operasi perniagaan.
AINNA Benchmark Arena akan membantu menjawab soalan-soalan operasi yang penting:
模型 manakah yang terbaik untuk analisis imej produk?
模型 manakah yang harus mengendalikan semakan pematuhan?
模型 manakah yang sesuai untuk dokumen panjang?
模型 manakah yang harus membaiki ralat sistem?
模型 manakah yang mencukupi untuk klasifikasi dan penandaan?
Bila sesuatu tugas harus dipertingkatkan ke model yang lebih kuat?
Di manakah kita boleh mengurangkan penggunaan token tanpa menurunkan kualiti?
Inilah arah yang kami percaya operasi AI harus tuju.
Bukan lebih besar kerana mahu kelihatan besar.
Bukan lebih mahal kerana mahu bergaya.
Bukan lebih kompleks kerana mahu kelihatan canggih.
Hanya model yang tepat, untuk tugas yang tepat, pada masa yang tepat.
Inilah prinsip di sebalik AINNA Benchmark Arena.
模型 Tepat. Tugas Tepat. Kurang Pembaziran.












Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. 电子邮件 diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
这篇文章适合团队用来开始讨论pendekatan sedemikian mungkin kelihatan baik。
我会把model manakah yang paling sesuai这一段分享给需要了解技术的同事。
视觉和结构让AINNA benchmark arena direka sebagai的概念更容易掌握。