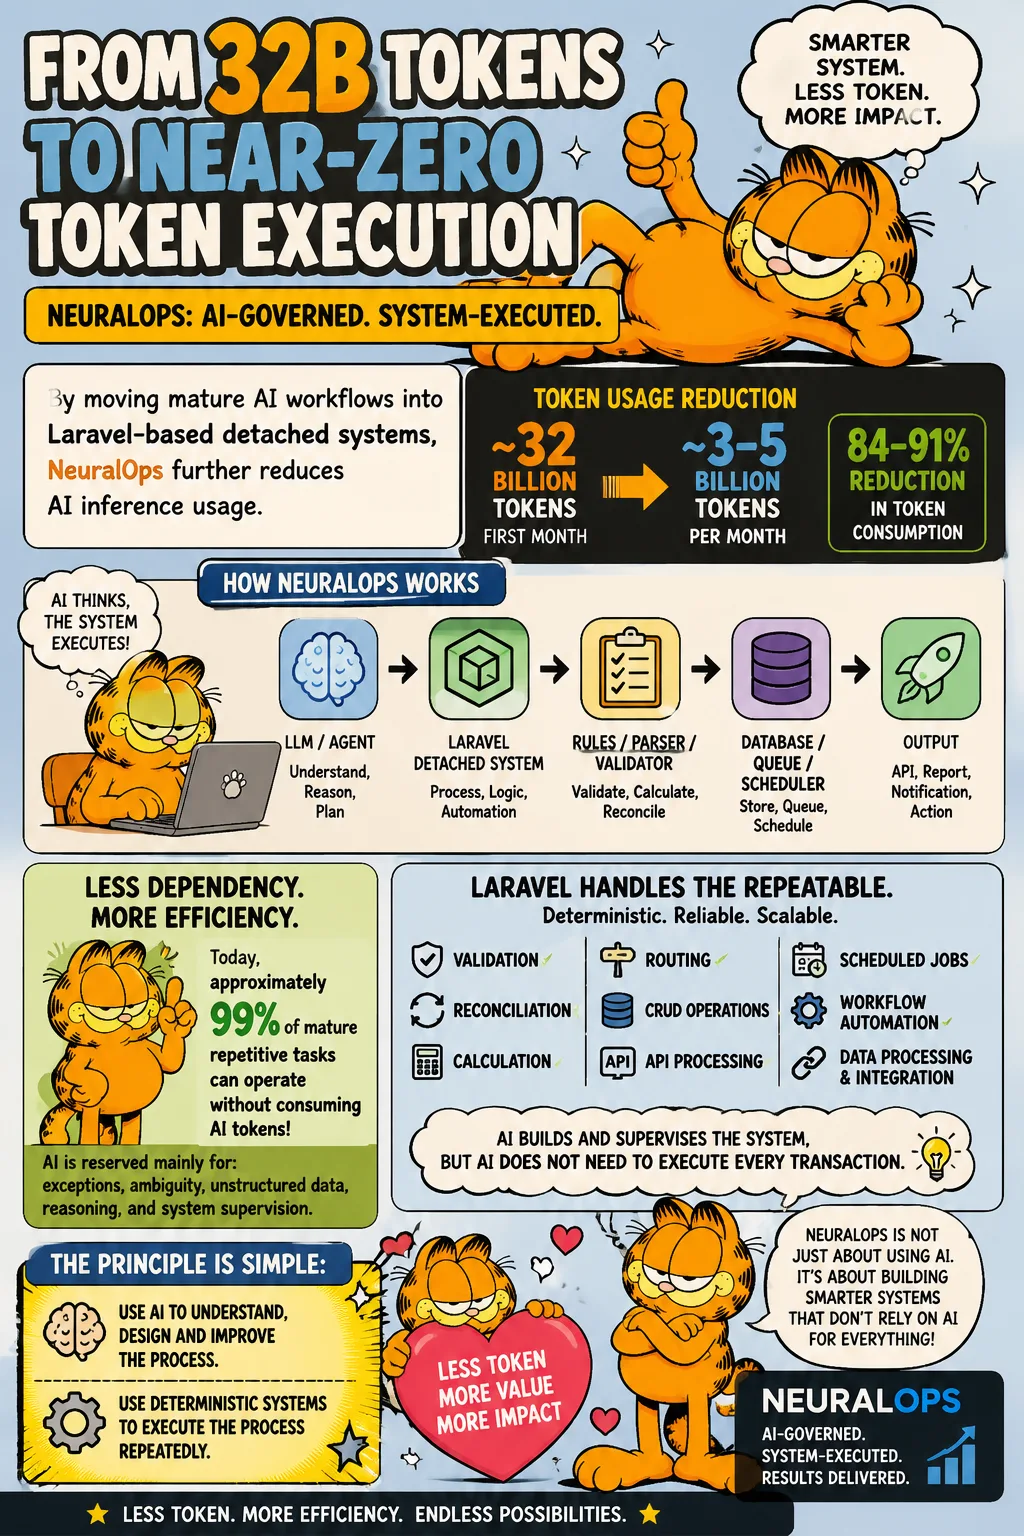
Dari sudut operasi, kami sentiasa cari cara supaya sistem AI tidak terpaksa buat inference setiap kali ada kerja berulang. Di AINNA, prinsip kerja kami mudah: biarkan AI faham dan reka proses, kemudian sistem deterministik yang jalankan proses itu berkali-kali.
Apabila workflow AI yang dah stabil dipindahkan ke sistem berasingan berasaskan Laravel, penggunaan token AI turun dengan ketara. Dalam kes kami, token usage jatuh dari kira-kira 32 billion token pada bulan pertama ke lebih kurang 3–5 billion token sebulan - penurunan anggaran 84–91% daripada penggunaan token.
Makin banyak tugas repetitif dan berstruktur yang kita migrate ke sistem Laravel berasingan, bergantungan kepada LLM inference pun makin kurang. Pada masa ini, anggaran 99% tugas berulang yang matang boleh jalan tanpa consume token AI. AI kita simpan untuk exception, data tidak berstruktur, reasoning, dan penyeliaan sistem.
Prinsip operasi kami mudah:
Guna AI untuk faham, reka dan baiki proses.
Guna sistem deterministik untuk jalankan proses berulang kali.
Inilah cara NeuralOps bergerak daripada automasi yang bergantung banyak kepada AI ke arah arkitektur AI-受治理的, 系统-executed yang lebih cekap.












Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. 电子邮件 diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
这篇文章适合团队用来开始讨论bergantungan kepada LLM inference pun。
视觉和结构让lebih kurang 3–5 5 billion的概念更容易掌握。
文章对biarkan AI faham dan reka提供了很好的起点,值得继续跟进。
文章把anggaran 84–91% da 91%和日常运营联系起来,这一点很有帮助。
我喜欢文章对penurunan anggaran 84– 84保持务实的态度。
难得有人把jatuh dari kira-kira 32 billion讲得这么直白。
总结部分让makin banyak tugas repetitif dan的重点更加清楚。
关于anggaran 99% t 99%的例子很实用,适合团队继续讨论。