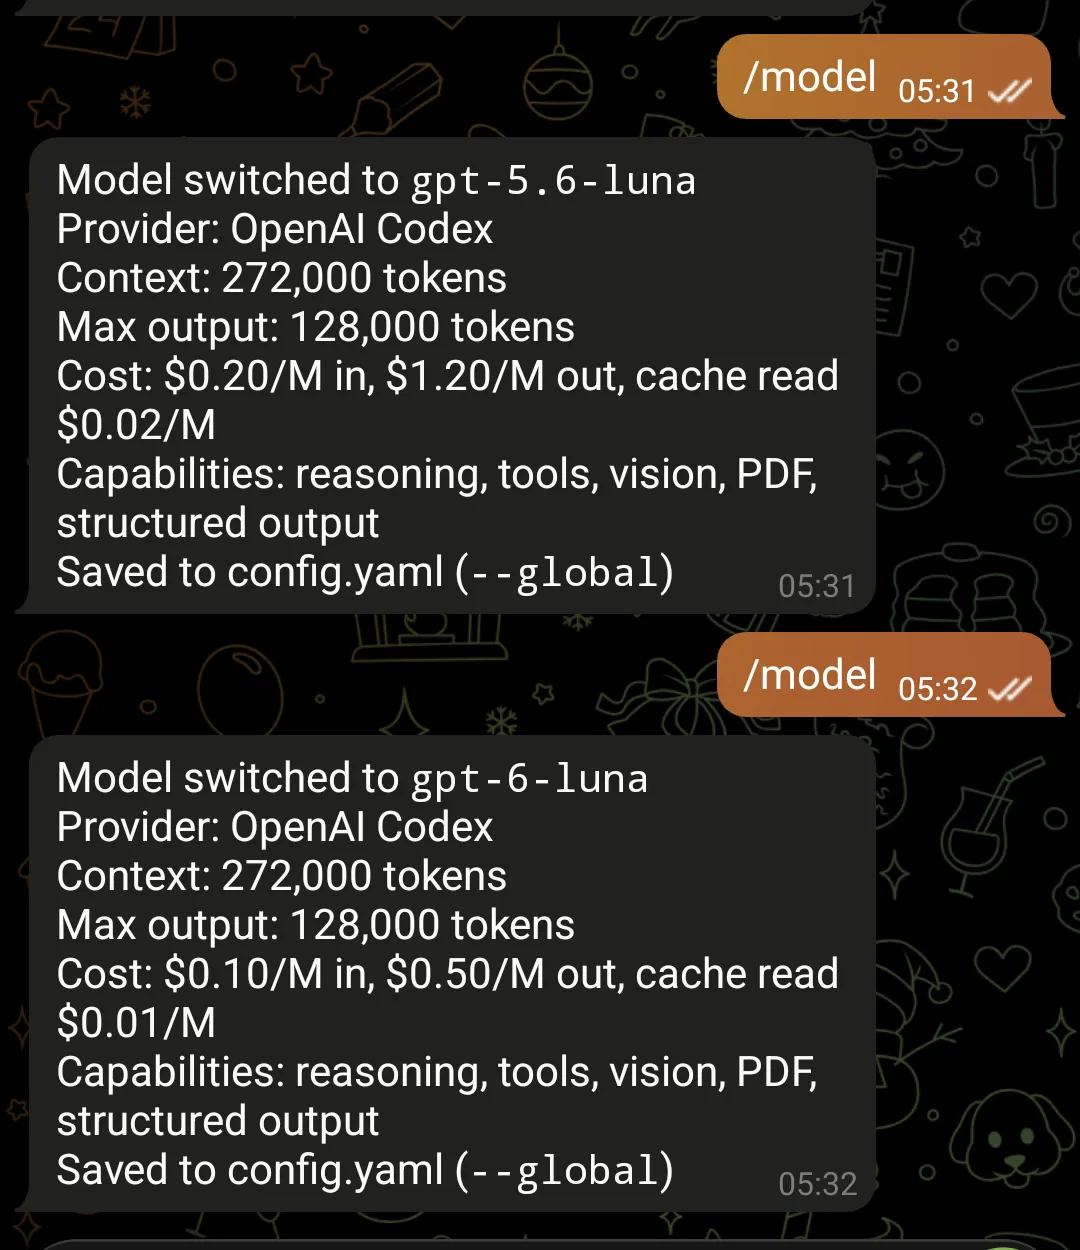
Perlumbaan AI Sebenar Mungkin Bukan Tentang 模型 Lebih Besar Mungkin Tentang Kecerdasan Lebih Murah
Bila saya tengok perbandingan ni, bahagian yang paling menarik bukan nama model tu.
Cerita yang lebih besar ialah keluk kos.
Dalam setup ni, harga turun dari lebih kurang $0.20/M input dan $1.20/M output ke $0.10/M input dan $0.50/M output, sambil kekalkan context window dan keupayaan tool yang sama seperti yang dinyatakan.
Kalau trend ni berterusan, ia akan ubah ekonomi pembinaan sistem AI.
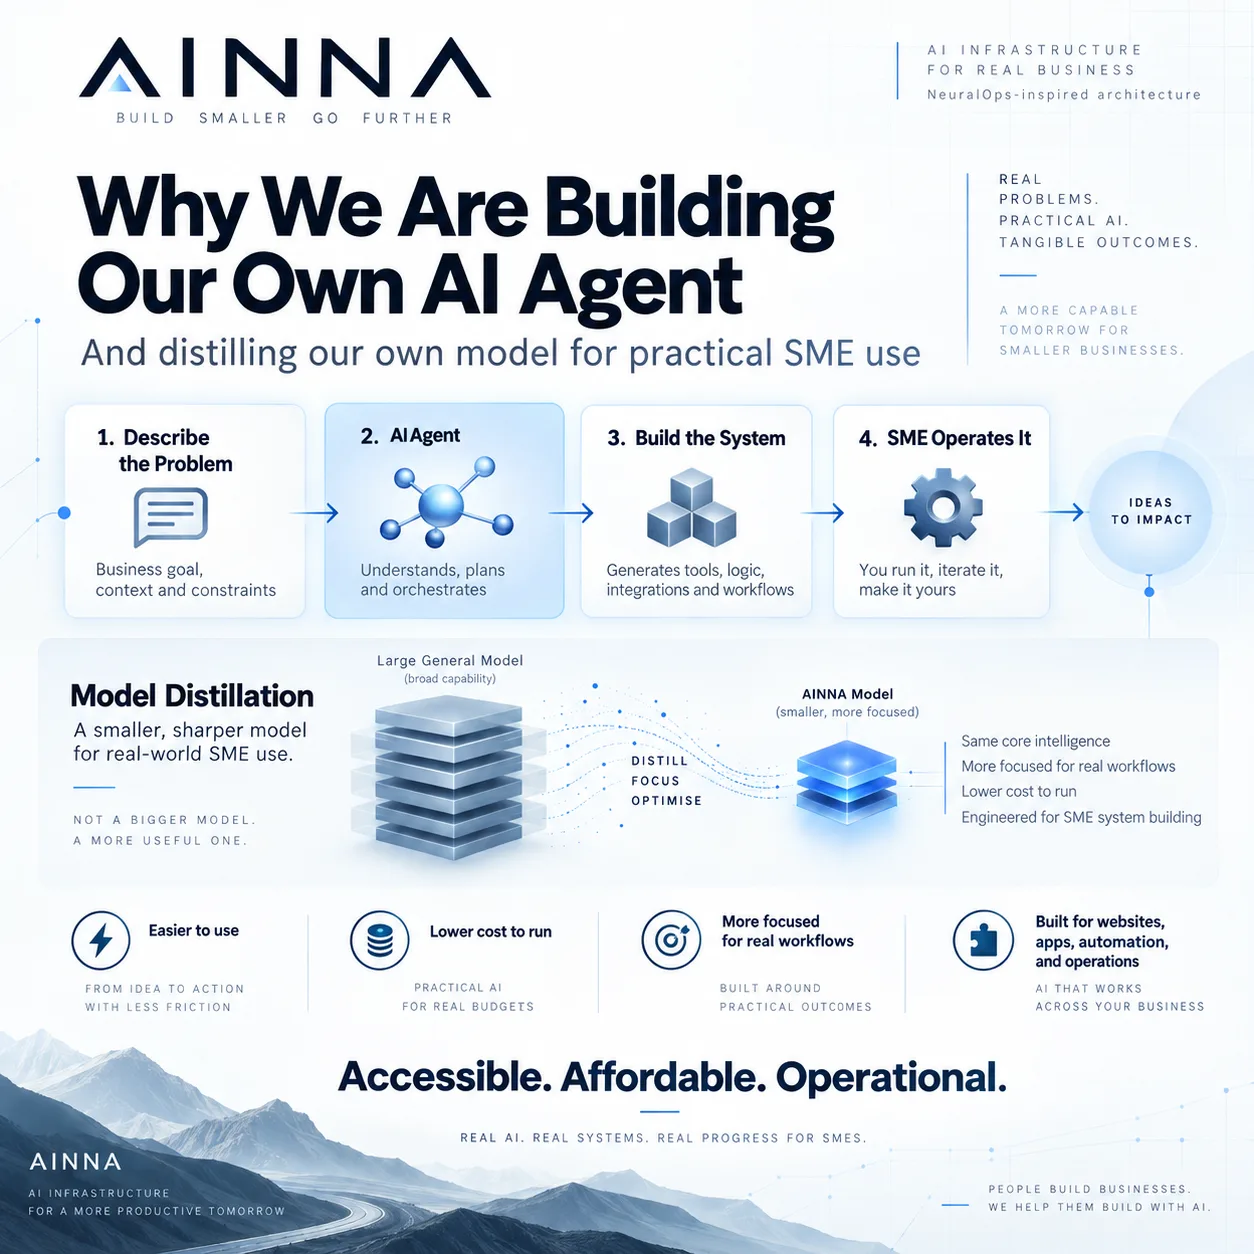
Bagi saya, ini satu lagi sebab kuat untuk bulk-distill LLM tempatan dan mungkin juga SLM.
Daripada bergantung selamanya pada external inference yang mahal, kita boleh guna model yang semakin optimum sebagai teacher untuk jana data latihan, refine workflow, bina corak reasoning khusus domain, dan terus tingkatkan model tempatan kita sendiri.
Sasaran bukan semestinya bina model paling besar.
Sasaran ialah bina model yang cukup optimum untuk kerja sebenar dia.
Bagi bisnes, maksudnya model lebih kecil boleh uruskan accounting, inventory, operasi, khidmat pelanggan, kawalan mesin, pemprosesan dokumen, listing SKU, atau automasi dalaman, sementara model external yang lebih besar hanya digunakan bila betul-betul perlu.
Saya harap trend harga ni berterusan.
Sekurang-kurangnya sampai LLM tempatan kita cukup matang untuk uruskan sebahagian besar workload secara bebas.
Guna model yang optimum untuk bina. Distill apa yang penting. Kurangkan kebergantungan dari semasa ke semasa.













Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. 电子邮件 diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
我会把sasaran bukan semestinya bina model这一段分享给需要了解技术的同事。
这篇文章适合团队用来开始讨论sambil kekalkan context window dan。
这篇内容让我更容易理解为什么kita boleh guna model yang值得关注。
文章对bahagian yang paling menarik bukan提供了很好的起点,值得继续跟进。
关于cerita yang lebih besar ialah的说明很完整,基础部分尤其清楚。
我喜欢文章对dan terus tingkatkan model tempatan保持务实的态度。