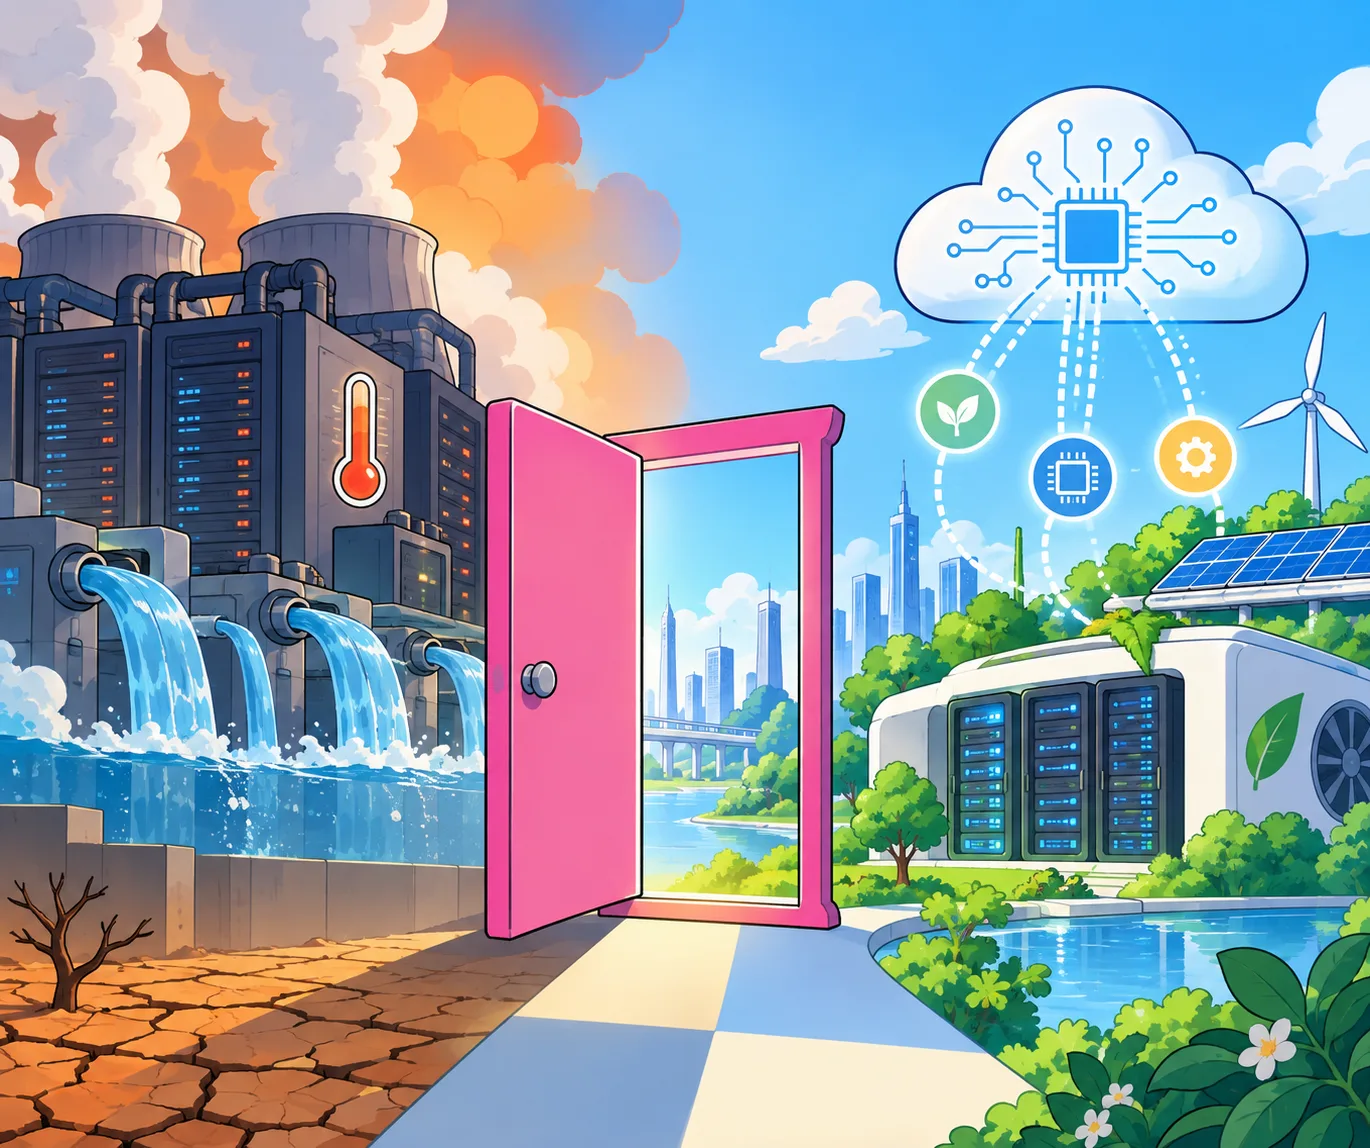
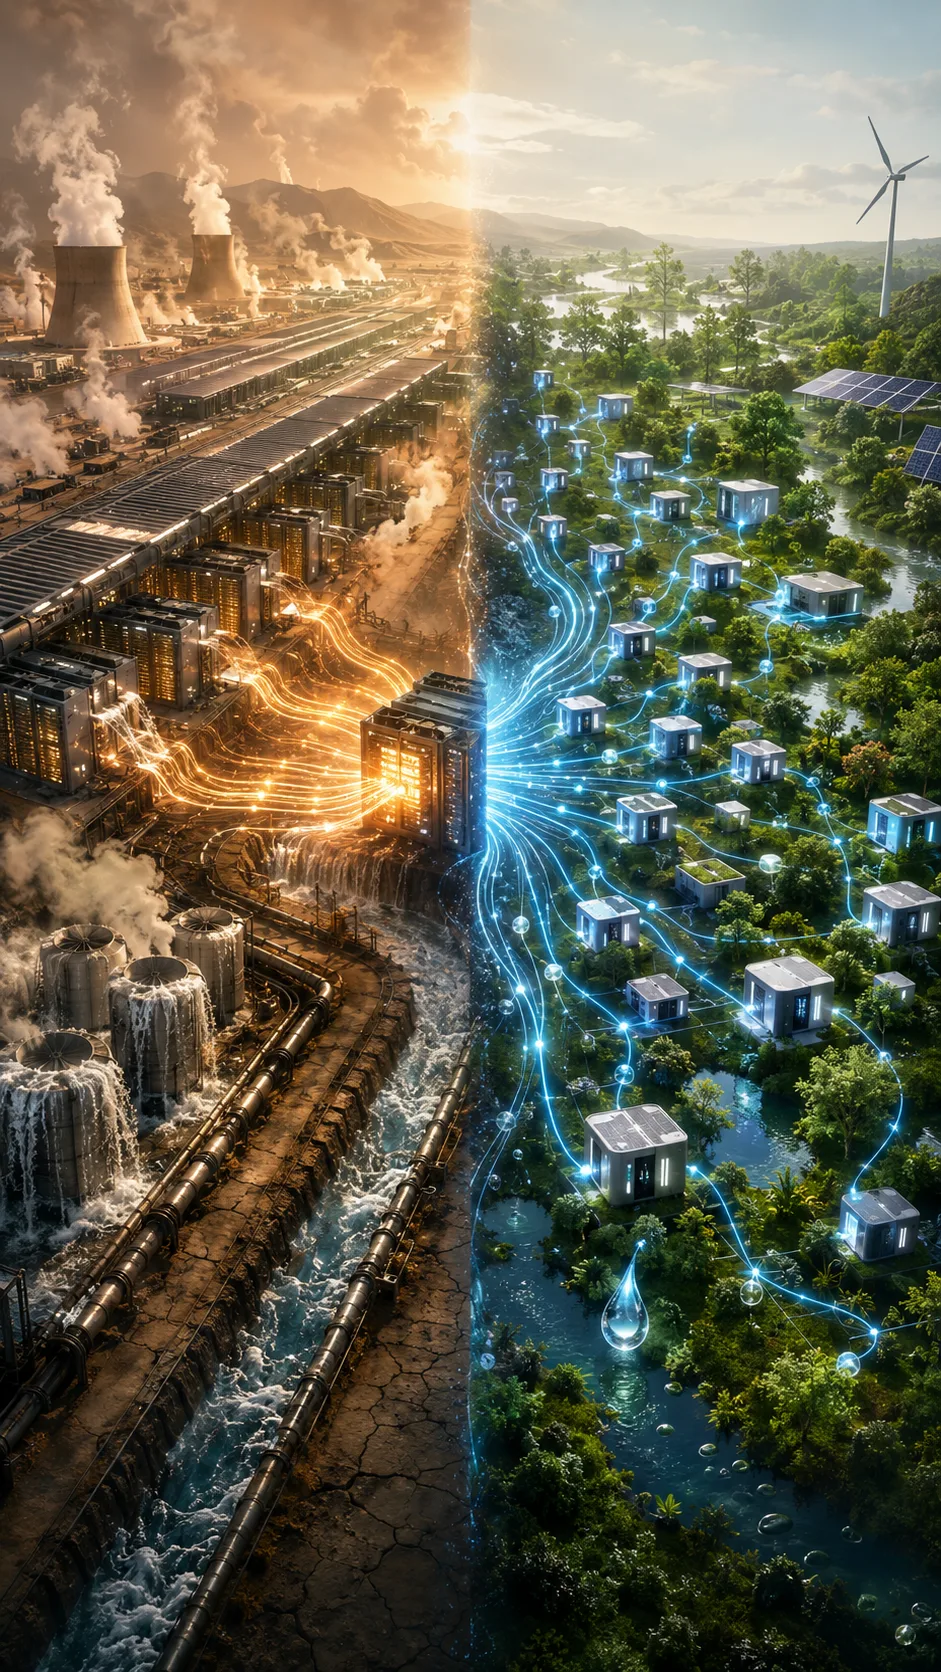
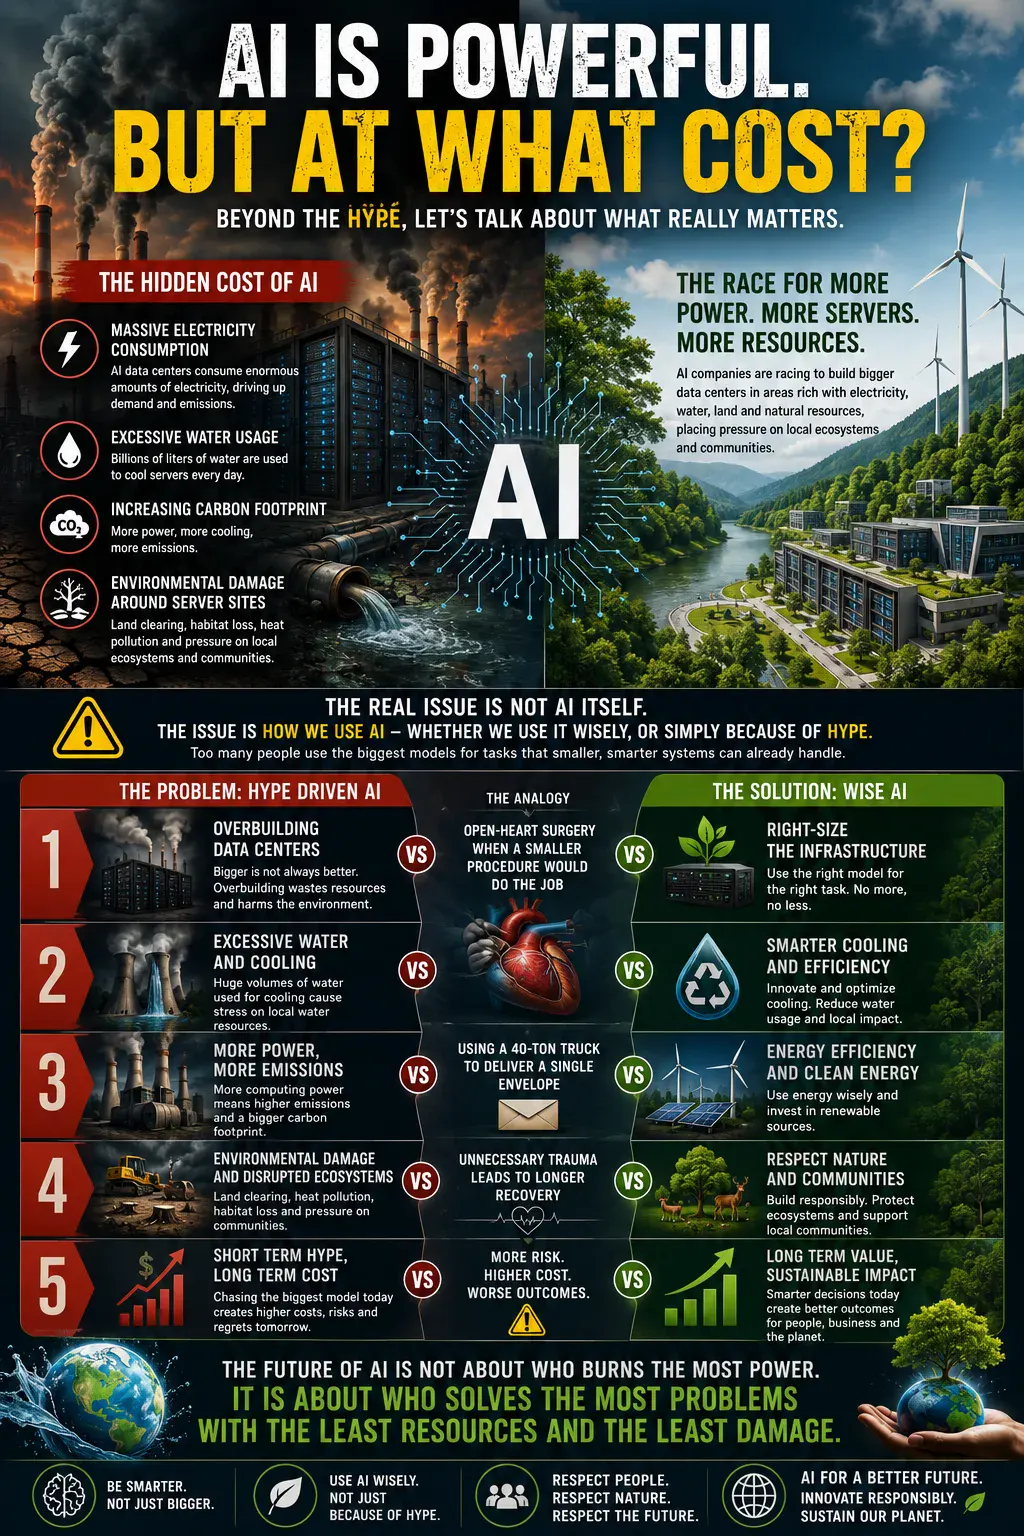
Ramai yang bercakap tentang AI yang menelan elektrik, menghasilkan haba, dan memberi tekanan kepada sumber air untuk penyejukan pusat data.
Tetapi mungkin kita sedang bertanya soalan yang salah.
Soalan itu tidak sepatutnya hanya:
“Berapa banyak tenaga yang AI gunakan?”
Ia juga sepatutnya:
“Mengapa kita menggunakan komputasi AI yang mahal untuk tugasan yang memang tidak pernah memerlukannya?”
Bukan setiap tugasan memerlukan model frontier.
Validasi mudah tidak memerlukan LLM besar.
Aliran kerja berulang seperti semakan 状态 penghantaran tidak memerlukan penaakulan mendalam.
Logik bisnes yang sudah diketahui, contohnya peraturan penghantaran mengikut SKU, tidak memerlukan ribuan token setiap kali ia berjalan.
Ini prinsip yang saya pegang dalam operasi logistik dan R&D di AINNA, dan yang kami bina dalam NeuralOps:
Gunakan AI termaju hanya apabila ia benar-benar diperlukan.
路线 tugasan mudah ke sistem deterministik.
Gunakan model lebih kecil atau lokal di tempat yang sesuai.
Cache hasil yang boleh diguna semula.
Kurangkan konteks dan pemprosesan token yang tidak perlu.
升级 ke model berkuasa hanya untuk masalah yang benar-benar memerlukannya.
Kurang komputasi yang tidak perlu bermakna kurang pemprosesan, kurang permintaan tenaga, dan kurang haba yang akhirnya perlu diurus.
Masa depan AI mampan bukan sekadar tentang membina pusat data yang lebih hijau.
Ia juga tentang membina seni bina AI yang lebih pintar sebelum beban kerja itu sampai ke pusat data.
Kecekapan AI bukan hanya masalah infrastruktur.
Ia masalah seni bina.
#Artificial智能 #可持续AI #GreenAI #NeuralOps #AI基础设施 #DataCenter #能源效率 #ESG #AgenticAI #DigitalTransformation


Ruang pembaca
Apa pendapat anda?
Komen disemak sebelum diterbitkan. 电子邮件 diperlukan untuk moderasi dan tidak dipaparkan kepada pembaca.
关于soalan itu tidak sepatutnya hanya的实际落地部分最吸引我。
如果可以继续说明dan yang kami bina dalam的真实案例,我会想继续阅读。
我会把validasi mudah tidak memerlukan LLM这一段分享给需要了解技术的同事。