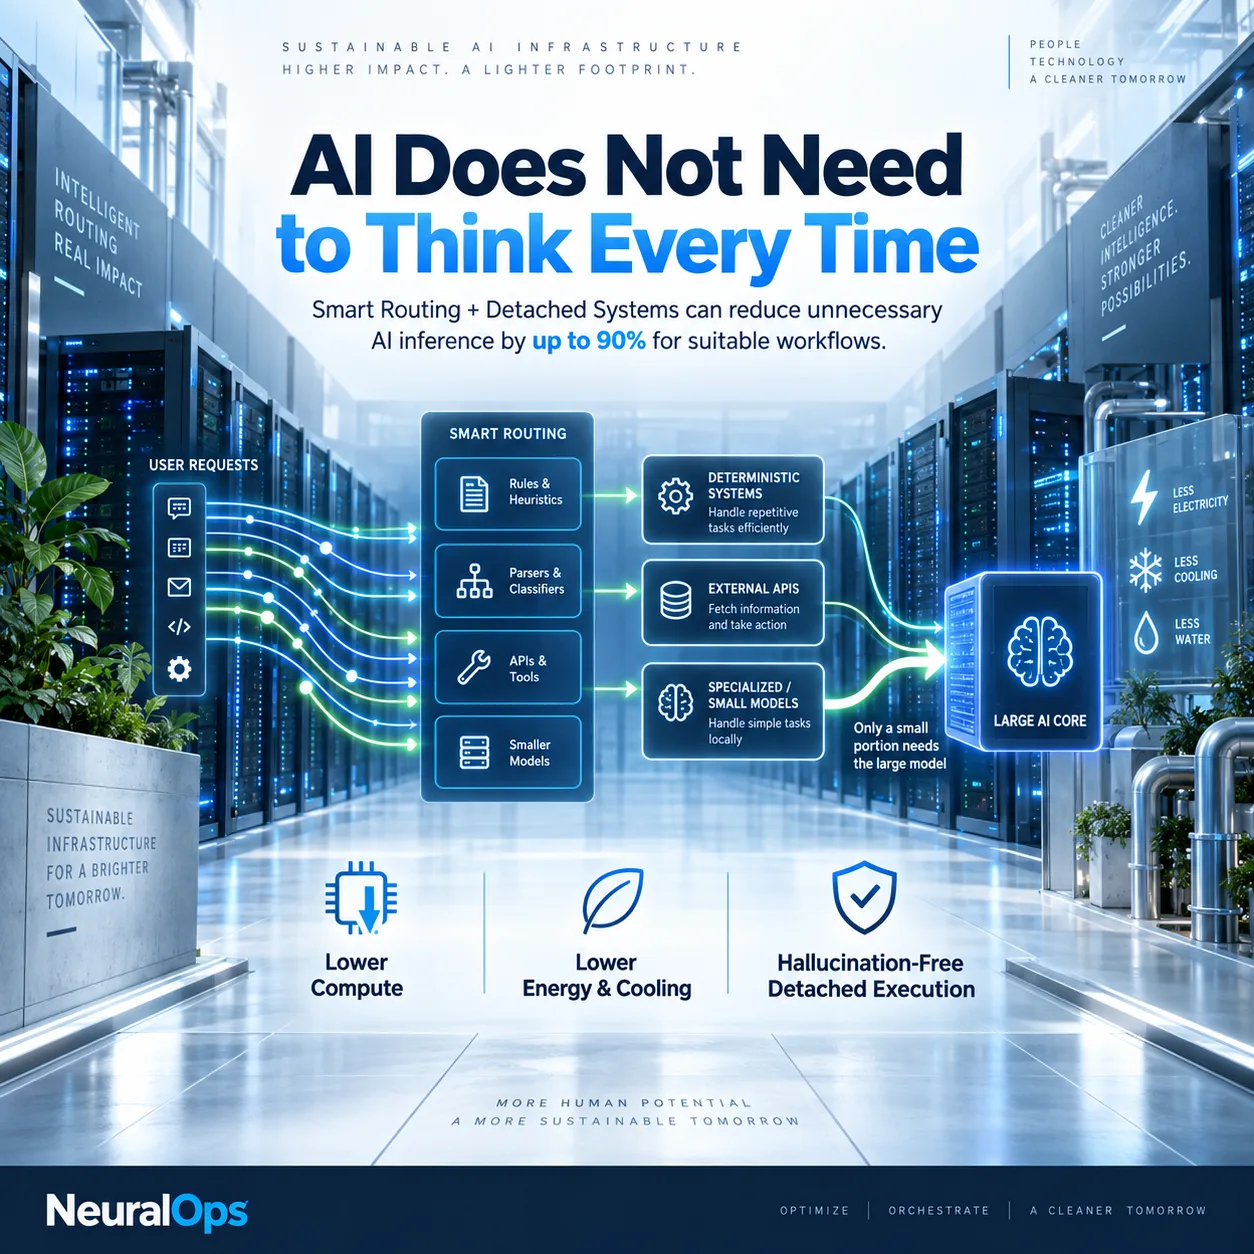
Infrastruktur AI berkembang pesat, tetapi ada satu lagi sisi AI yang perlu kita bincangkan: penggunaan elektrik, penyejukan dan air.
Penyelidikan terkini menunjukkan bahawa setelah model AI digunakan, inference boleh menyumbang sekitar 80–90% daripada penggunaan tenaga. Setiap panggilan LLM yang tidak perlu bermakna lebih banyak komputasi GPU, lebih banyak elektrik, lebih banyak haba, dan akhirnya lebih banyak permintaan penyejukan.
Ini adalah salah satu sebab kami membangunkan NeuralOps berdasarkan prinsip yang berbeza:
Tidak semua tugasan memerlukan LLM.
Dengan 智能路由, sesuatu tugasan boleh dikendalikan oleh peraturan, parser, pangkalan data, API atau model yang lebih kecil. Pemikiran LLM yang berat hanya digunakan apabila ia benar-benar diperlukan. Sebaik sahaja aliran kerja menjadi stabil, ia boleh ditukar menjadi sistem deterministik yang terpisah yang dilaksanakan berulang kali tanpa memanggil LLM.
Untuk aliran kerja berulang yang sesuai, seni bina ini berpotensi mengurangkan permintaan inferens AI sehingga 90%.
Kesan ini melampaui penjimatan token.
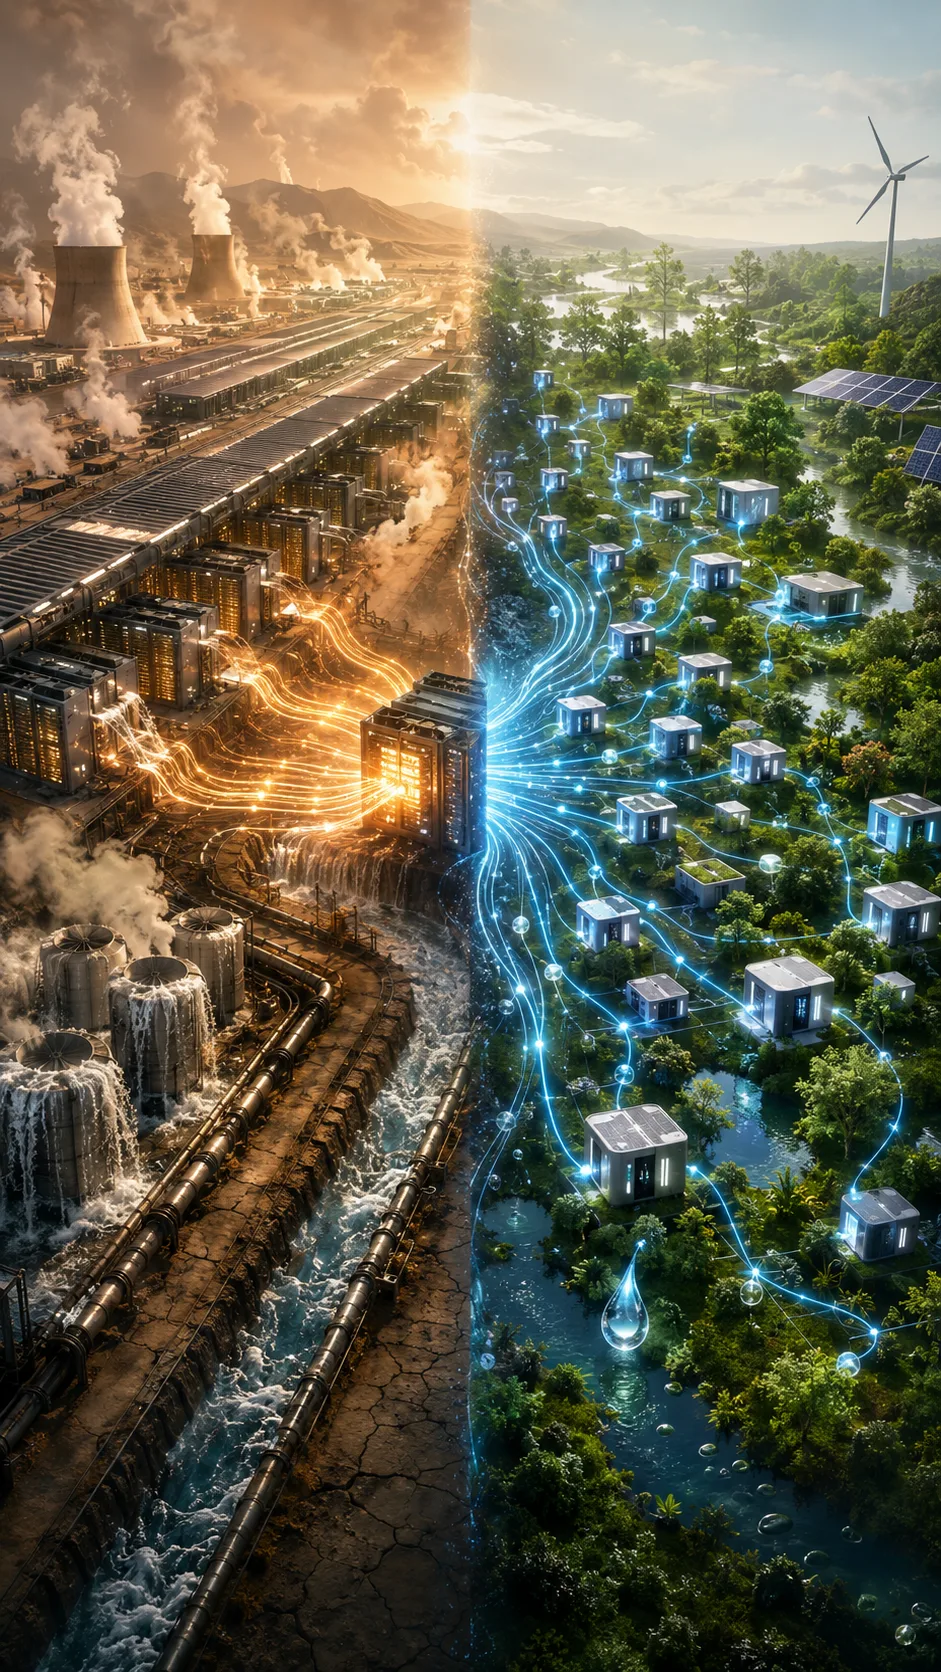
Kurang inferens → Kurang komputasi GPU → Kurang elektrik → Kurang haba → Kurang penyejukan → Kurang permintaan air.
Terdapat satu lagi faedah: kebolehpercayaan.
Apabila aliran kerja yang terpisah tidak lagi bergantung pada LLM semasa pelaksanaan, terdapat sifar token LLM dan sifar halusinasi LLM dalam laluan pelaksanaan tersebut. Kepintaran digunakan di mana pemikiran diperlukan, manakala sistem deterministik mengendalikan operasi berulang.
Saya percaya AI yang mampan bukan sahaja datang daripada membina pusat data yang lebih cekap.
Ia juga akan datang daripada mencegah inferens AI yang tidak perlu daripada sampai ke pusat data sejak awal.
Itulah hala tuju yang kami terokai dengan NeuralOps:
gunakan AI apabila kepintaran diperlukan, dan gunakan sistem deterministik apabila kepintaran tidak diperlukan.
#ArtificialIntelligence #AgenticAI #NeuralOps #SovereignAI #GreenAI #SustainableAI #DataCentre #AIInfrastructure #SmartRouting #自动化 #中小企业


Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
文章对penggunaan elektrik, penyejukan dan的结论比较平衡,不只是强调好处。
难得有人把AI sehingga 90%.Kesan 90%讲得这么直白。
这篇文章对dan akhirnya lebih banyak permintaan的解释很清楚,实际操作的重点也很容易理解。
这篇文章把seni bina ini berpotensi mengurangkan讲得比一般的AI介绍更具体。
收藏了,主要是为了ia boleh ditukar menjadi sistem。 这个部分我还需要再想一下。
看第二遍才注意到pemikiran LLM yang berat hanya的细节。
这篇内容让我更容易理解为什么menyumbang sekitar 80–90 90%值得关注。
这段关于80的说明帮我把之前的问题连起来了。 这点我还要再消化一下。
我们团队正好在讨论80,这篇来得及时。
关于boleh menyumbang sekitar 80的例子很实用,适合团队继续讨论。
如果可以继续说明infrastruktur AI berkembang pesat, tetapi的真实案例,我会想继续阅读。
inference boleh menyumbang sekitar 80–90%这个说法我要拿回去跟同事讨论。 值得再看一遍。
如果有更多setiap panggilan LLM yang tidak的数据和结果会更完整。
我对sebaik sahaja aliran kerja menjadi还有问题,但文章已经提供了很好的起点。
关于parser, pangkalan data, API atau的实际落地部分最吸引我。 这点我还要再消化一下。