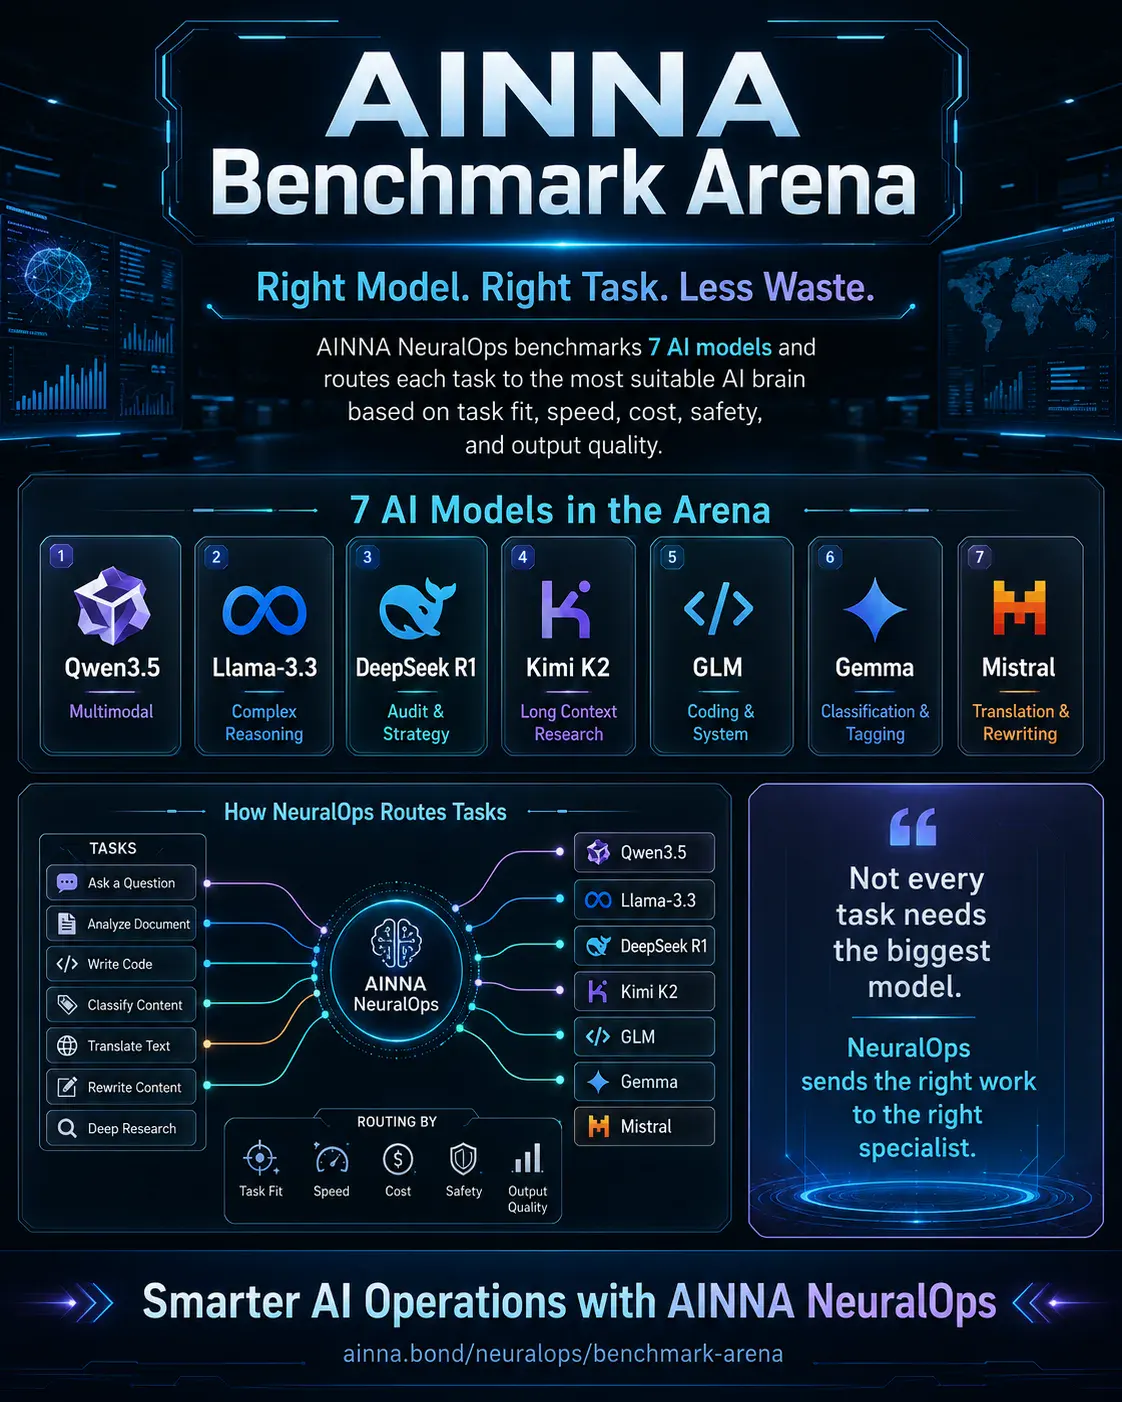
AINNA 基准竞技场:正确的模型,正确的任务,更少的浪费。
Masa depan operasi AI bukanlah tentang memaksa model terbesar untuk setiap tugas.
Sebagai pemilik perniagaan, anda mungkin pernah mendengar cerita mengenai model AI yang semakin besar dan semakin canggih. Pada kertas, ia kelihatan menggiurkan. Tetapi dalam operasi sebenar-di kedai, di gudang, di pejabat, di pasaran digital-pendekatan itu seringkali membawa kos tersembunyi, perlaksanaan yang lebih perlahan, penggunaan token yang tinggi, dan pembaziran sumber komputasi. Di AINNA, kami percaya soalan yang lebih bijak bukanlah, "模型 AI yang manakah paling berkuasa?" Soalan sebenarnya ialah, "模型 yang manakah paling sesuai untuk tugas tertentu ini?"
Itulah sebab di sebalik AINNA Benchmark Arena.
AINNA Benchmark Arena direka bentuk sebagai lapisan penilaian dan penghalaan model untuk AINNA NeuralOps. Ia menilai prestasi model AI yang berbeza berdasarkan keperluan operasi sebenar seperti analisis multimodal, penyelidikan dokumen panjang, semakan pematuhan, pengaturcaraan, pembaikan sistem, klasifikasi, penandaan, terjemahan, penulisan semula, dan penaakulan strategik.
Dalam tumpukan NeuralOps kami, setiap model memainkan peranan tertentu. Qwen3.5 ditugaskan untuk tugas multimodal yang melibatkan teks, imej, tangkapan skrin, dan visual produk. Llama-3.3 digunakan untuk penaakulan kompleks dan tugas umum yang memerlukan tahap tinggi. DeepSeek R1 diposisikan untuk audit, pematuhan, semakan risiko, dan perancangan strategik. Kimi K2 digunakan untuk penyelidikan konteks panjang dan analisis dokumen berat. GLM ditugaskan kepada pengaturcaraan, penjanaan sistem, dan pembaikan teknikal. Gemma mengendalikan klasifikasi pantas, penandaan, dan pengesanan niat. Mistral menyokong terjemahan, penulisan semula, dan penajaman bahasa.
Inilah tempat 智能路由 menjadi penting.
Setiap tugas tidak memerlukan model raksasa. Klasifikasi mesej pelanggan yang ringkas tidak memerlukan lapisan kecerdasan yang sama seperti audit pematuhan strategik. Tag produk pendek tidak memerlukan komputasi yang sama seperti perbandingan dokumen panjang. Pembaikan pepijat laman web tidak memerlukan model yang sama seperti analisis imej poster. Setiap tugas berhak mendapat pakar yang tepat.
Satu analogi yang berguna ialah sistem kesihatan. Setiap kes tidak memerlukan pakar bedah kardiothoraks. Sesetengah kes memerlukan jururawat triaj. Sesetengah memerlukan doktor umum. Sesetengah memerlukan pakar. Sesetengah memerlukan juruaudit. Sesetengah memerlukan jurutera. Pemikiran yang sama terpakai dalam operasi AI. Apabila pakar yang betul menangani tugas yang betul, seluruh sistem menjadi lebih pantas, lebih bersih, dan lebih cekap.
AINNA Benchmark Arena bukan sekadar papan pendahulu. Ia tidak dibina untuk menobatkan satu model sebagai juara mutlak. Sebaliknya, ia mengukur prestasi model merentasi beberapa dimensi operasi: ketepatan, kesesuaian tugas, kelajuan, kecekapan kos, keselamatan pematuhan, dan tahap penyuntingan manusia yang diperlukan.
Ini penting kerana penggunaan AI dalam dunia sebenar bukan sahaja tentang kecerdasan. Ia juga tentang kemampanan, konsistensi, kos operasi, dan kawalan risiko.
模型 yang memberi jawapan indah tetapi memerlukan penyuntingan berat tidak semestinya pilihan terbaik. 模型 yang sangat bijak tetapi terlalu mahal untuk tugas mudah tidak cekap secara operasi. 模型 yang pantas tetapi lemah dalam semakan pematuhan tidak patut digunakan untuk tuntutan sensitif. Matlamatnya bukan untuk menggunakan lebih banyak AI. Matlamatnya ialah untuk menggunakan AI dengan lebih bijak.
Bagi AINNA, ini menyokong visi yang lebih besar: NeuralOps sebagai lapisan operasi untuk pelaksanaan AI yang cekap. Visi ini bukan sekadar teknikal-ia tentang membantu perniagaan 马来西亚 menggunakan AI sebagai alat pertumbuhan, bukan beban kos.
Gabungan penanda aras, 智能路由, dan pelaksanaan terpisah membolehkan kami mengurangkan komputasi yang tidak perlu sambil meningkatkan kualiti output. Berbanding dengan mengekalkan setiap ejen atau model aktif sepanjang masa, AINNA NeuralOps hanya mengaktifkan keupayaan yang tepat apabila diperlukan. Ini menghasilkan seni bina AI yang lebih praktikal, lebih ekonomi, dan boleh skala mengikut saiz perniagaan anda.
AINNA Benchmark Arena akan membantu menjawab soalan operasi penting:
模型 yang manakah terbaik untuk analisis imej produk?
模型 yang manakah patut mengendalikan semakan pematuhan?
模型 yang manakah terbaik untuk dokumen panjang?
模型 yang manakah patut membaiki ralat sistem?
模型 yang manakah mencukupi untuk klasifikasi dan penandaan?
Bilakah tugas perlu dinaik taraf kepada model yang lebih kuat?
Di manakah kita boleh mengurangkan penggunaan token tanpa mengurangkan kualiti?
Inilah arah yang kami percaya operasi AI patut bergerak-terutamanya untuk perniagaan 马来西亚 yang mahu berkembang dengan bijak.
Bukan lebih besar semata-mata kerana mahu lebih besar.
Bukan mahal semata-mata kerana prestij.
Bukan kompleks semata-mata kerana kelihatan canggih.
Hanya model yang tepat, untuk tugas yang tepat, pada masa yang tepat. Itulah cara kami memastikan setiap ringgit dan setiap saat yang anda laburkan dalam AI memberi nilai sebenar.
Itulah prinsip di sebalik AINNA Benchmark Arena.
模型 Tepat. Tugas Tepat. Pembaziran Berkurang.


Ruang pembaca
Apa pendapat anda?
Komen baharu dihantar untuk semakan terlebih dahulu. 名称 dan email diperlukan, tetapi email tidak dipaparkan kepada pembaca.
关于dan pembaziran sumber komputasi的例子很实用,适合团队继续讨论。
第一次看到有人把3.5讲得这么坦白。
关于3.5的数字比我平时看到的大多数文章靠谱。 这点我还要再消化一下。
如果可以继续说明masa depan operasi AI bukanlah的真实案例,我会想继续阅读。
如果有更多visual produk. llama-3.3 3.3的数据和结果会更完整。
perlaksanaan yang lebih perlahan, penggunaan这个说法我要拿回去跟同事讨论。
这篇内容让我更容易理解为什么penyelidikan dokumen panjang, semakan值得关注。 值得再看一遍。
文章把model yang manakah paling sesuai和日常运营联系起来,这一点很有帮助。
总结部分让model AI yang manakah paling的重点更加清楚。
同意作者对ia menilai prestasi model AI的判断,但执行起来还有难度。 这个部分我还需要再想一下。
这篇文章对pada kertas, ia kelihatan menggiurkan的解释很清楚,实际操作的重点也很容易理解。
这篇文章适合团队用来开始讨论di AINNA, kami percaya soalan。
我会把penandaan, terjemahan, penulisan semula, dan这一段分享给需要了解技术的同事。
视觉和结构让tetapi dalam operasi sebenar-di kedai的概念更容易掌握。
难得有人把anda mungkin pernah mendengar cerita讲得这么直白。
关于pengaturcaraan, pembaikan sistem, klasifikasi的风险和限制还可以再展开,不过基础说明已经很好。